首页
>
资讯中心 >
文章详情
Google搜索引擎怎么工作?米多多SEO小课堂
来源:米多多官方 | 作者:匿名
发布时间:
2026-08-05 15:05:17
热门资讯
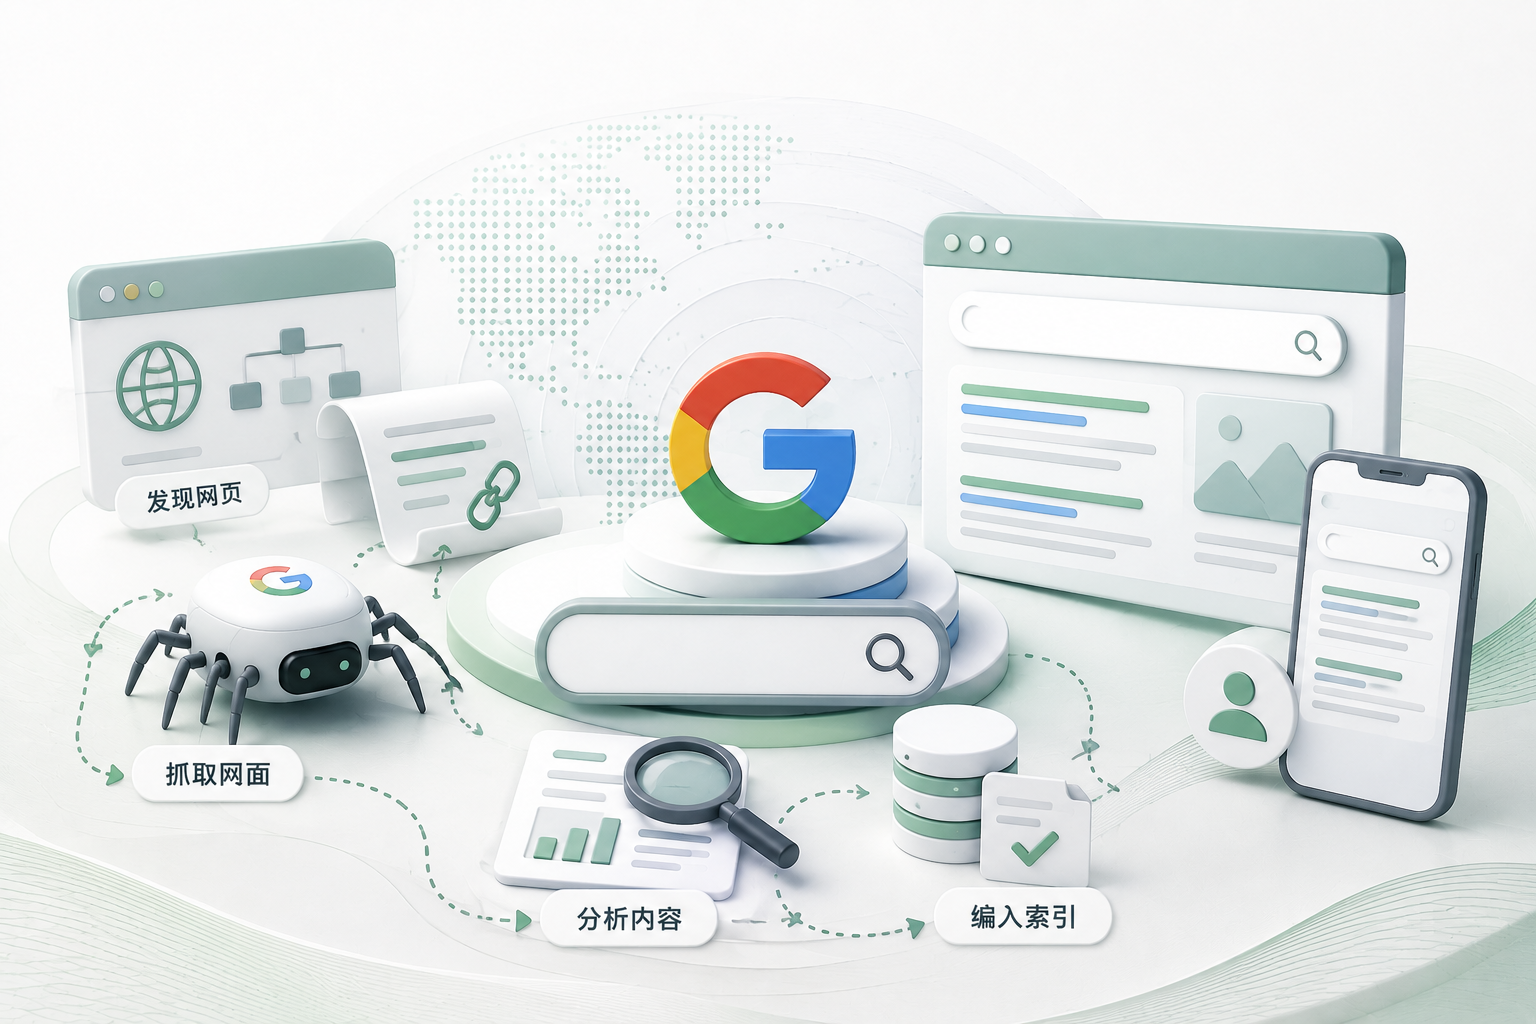
Google搜索引擎的工作原理主要包括收录与搜索两个阶段:(1)收录:Google发现网页网址 → Google爬虫访问并抓取页面 → 处理和分析页面内容 → 将符合条件的信息存入Google索引;(2)搜索:用户输入搜索词 → Google从索引中检索相关内容 → 根据相关性、内容质量及用户搜索环境等因素进行排序 → 将搜索结果呈现给用户。
从更细的技术环节看,整个过程还可以分为抓取、索引和提供搜索结果。这里将发现网址、抓取页面和编入索引归入“收录”过程,再将检索、排序与结果展示归入“搜索”过程。米多多在独立站SEO运营中通常会先确认页面能否被Google发现、抓取和编入索引,再分析关键词展示、点击与排名表现。
 1. Google如何发现并抓取网页?
互联网上不存在登记全部网页的统一目录,因此Google需要不断寻找新页面和已经更新的页面。部分网址是Google以前访问过的,部分新网址则会通过其他网页中的链接、网站内部链接或网站地图被发现,这一过程可以理解为网址发现。
对于刚上线的独立站,清晰的网站导航、产品分类和内部链接可以帮助Google从首页进入产品页、文章页和其他重要页面。XML网站地图则可以集中提供网站中的重要网址,帮助Google了解网站包含哪些页面,但提交网站地图并不代表其中的页面一定会被抓取或收录。
Google发现网址后,可能会使用名为Googlebot的自动化抓取工具访问页面,下载页面中的文字、图片、视频及其他可用资源。Google会根据系统判断决定抓取哪些网站、多久抓取一次,以及每次抓取多少页面。
网站服务器异常、DNS错误、页面加载失败或访问速度长期不稳定,都可能影响Googlebot访问页面。robots.txt则主要用于控制搜索引擎爬虫可以请求哪些网址,如果重要产品页或文章页被错误禁止抓取,Google可能无法正常读取页面内容。
网站中的链接还需要能够被Google识别和访问。产品列表只有图片却没有清晰链接、重要内容必须点击复杂按钮后才能出现,或者页面长期处于登录状态,都可能增加Google发现和抓取内容的难度。
2. 页面被抓取后如何进入Google索引?
页面被抓取后,Google会处理和分析其中的文字、标题、图片、视频、Alt属性及其他页面信息,尝试判断页面主要表达什么内容。对于使用JavaScript生成内容的网站,Google还可能通过浏览器环境渲染页面并执行JavaScript,以查看最终能够显示的内容。
如果产品名称、介绍、参数或文章正文只能在用户点击后加载,或者JavaScript运行异常,Google看到的页面内容可能与访客实际看到的内容不同。企业需要保证页面主要内容能够稳定加载,并避免将重要产品信息完全依赖复杂互动后才显示。
分析页面时,Google还会识别页面语言、内容主题、图片和视频信息,并判断页面是否与其他网址重复或高度相似。如果多个网址展示相同或近似内容,Google可能将它们归为同一组,并从中选择更具有代表性的规范网页。
筛选参数、排序方式、HTTP与HTTPS版本、带有不同跟踪参数的网址,都可能产生内容相近的页面。企业可以通过规范网址、统一内部链接和合理设置页面结构,帮助Google理解希望主要展示的页面,但Google仍会综合多个信号选择其认为合适的规范版本。
符合条件的页面信息会被存储在Google索引中。页面进入索引后,才具备出现在Google搜索结果中的资格。不过,进入索引并不代表页面搜索任何关键词时都会展示,也不代表一定能够获得靠前排名。
3. 发现、抓取、收录和排名有什么区别?
网页被Google发现,只能说明Google已经知道这个网址存在,并不代表Googlebot已经访问页面。页面被抓取后,也不代表一定会被编入索引;进入索引后,还要等到页面与用户查询相关时,才可能出现在对应的搜索结果中。
因此,被发现、被抓取、被收录和获得排名是不同阶段。企业不能只根据页面是否能够在Google中搜索到,判断整个网站的SEO是否正常,也不能把提交网址理解为立即收录或获得排名。
页面未被收录可能与内容质量较低、页面重复、设置了noindex、服务器异常、网站结构不利于抓取或Google选择了其他规范网页有关。即使页面符合Google搜索要求,Google也不保证一定会抓取、编入索引或展示该页面。
robots.txt与noindex的作用也不相同。robots.txt主要用于管理爬虫访问,不能作为确保网页不出现在Google搜索结果中的方式;noindex则用于告诉Google不要将页面保留在搜索结果中,但Google需要能够抓取页面,才能读取其中的noindex规则。
米多多检查独立站收录问题时,会按照网址是否被发现、Googlebot能否访问、页面能否正常渲染、是否允许索引、规范网页是否正确的顺序逐项排查。这样可以判断问题发生在哪个环节,避免在抓取尚未正常时就反复修改关键词和文章内容。
4. 用户搜索后Google如何检索和排序?
用户在Google中输入搜索词后,系统会从已经建立的Google索引中查找与搜索需求相关的内容,而不是在用户搜索的瞬间重新抓取整个互联网。Google会分析查询中的词语、组合方式和可能表达的需求,再从索引中筛选相关页面。
找到相关内容后,Google会通过自动化排名系统对结果进行排序。排序过程中会综合考虑页面与查询的相关性、内容质量、页面可用性及用户搜索环境等多种因素,并尝试优先展示更相关和更有帮助的信息。
例如,不同国家和地区的用户搜索同一个词时,看到的结果可能不同;用户使用的语言、所在位置和访问设备,也可能影响搜索结果的内容与展示形式。对于具有明显地区需求的查询,本地相关信息可能获得更多展示机会。
Google的排名系统通常以具体页面为主要判断对象,同时也会参考部分网站层面的信号。某个网站整体表现较好,并不代表其中所有页面都会获得靠前排名;个别页面表现一般,也不代表整个网站的内容都无法展示。
完成检索和排序后,Google会将相应结果呈现在搜索结果页面中。根据查询内容不同,结果中可能出现普通网页、图片、视频、本地信息、商品及其他搜索功能。页面已经被收录,也只有在内容与用户查询具有相关性并符合相应展示要求时,才可能获得展示。
5. 独立站如何检查抓取、收录和搜索表现?
企业可以通过Google Search Console查看网站的抓取、索引和搜索表现。网址检查工具可以显示具体页面当前的索引状态,也可以测试实时网址,帮助企业了解Google能否访问页面及其读取到的相关信息。
网站地图可以通过Search Console提交,页面索引报告则可以用于查看哪些网址已经进入索引、哪些页面没有收录以及系统识别到的主要原因。对于重要的新页面或完成明显修改的页面,还可以根据实际情况提交抓取请求,但提交请求仍不代表页面一定会立即收录。
效果报告可以查看网站通过哪些搜索词获得展示和点击,并分析页面、国家、设备、展示次数、点击次数和平均排名等数据。企业可以据此判断目标关键词是否带来曝光,哪些页面已经获得访问,以及不同市场的搜索表现是否存在差异。
在米多多的独立站SEO内容运营中,Search Console数据通常会与产品更新、文章发布、页面结构和目标市场结合分析。如果页面长期没有被发现,需要检查链接与网站地图;如果已经抓取但未收录,需要检查内容、规范网页和索引设置;如果已经收录但没有展示,则需要进一步分析页面主题、搜索需求和内容质量。
企业还需要定期检查服务器状态、robots.txt、noindex、规范网址、内部链接、多语言页面和移动端内容,避免网站改版或功能调整后影响Google抓取与索引。SEO需要持续维护,不能在网站上线并提交网站地图后就停止检查。
Google搜索引擎工作原理常见问题
Q:提交网站地图后,页面会立即被Google收录吗?
A:不会。网站地图可以帮助Google发现网址,但不能保证页面立即被抓取或编入索引。
Q:页面被Googlebot抓取后是不是就代表已经收录?
A:不是。抓取后Google还会分析页面内容和索引条件,被抓取不等于被收录。
Q:页面已经收录,为什么搜索关键词时仍然找不到?
A:收录只代表页面具备参与搜索结果展示的资格,是否出现还取决于查询相关性、内容质量和排名系统判断。
Q:使用robots.txt能彻底阻止网页出现在Google吗?
A:不一定。robots.txt主要管理爬虫访问,网址仍可能通过其他链接被发现。需要阻止索引时,应根据实际情况使用noindex或访问权限控制。
Q:如何查看网页是否已被Google收录?
A:可以使用Google Search Console中的网址检查工具和页面索引报告,查看具体页面的抓取与索引状态。
米多多可以提供什么
围绕外贸独立站的Google自然搜索运营,米多多可以根据网站结构、产品分类和目标市场,协助检查网站地图、robots.txt、noindex、规范网址、内部链接和多语言页面等基础设置,并通过Google Search Console分析页面发现、抓取、索引、搜索词展示和点击情况。在内容运营方面,米多多还可以结合海外客户的搜索需求,规划产品页面、行业文章、常见问题和落地页内容,持续检查收录与搜索表现,使网站技术设置、内容更新和SEO数据复盘形成衔接。
1. Google如何发现并抓取网页?
互联网上不存在登记全部网页的统一目录,因此Google需要不断寻找新页面和已经更新的页面。部分网址是Google以前访问过的,部分新网址则会通过其他网页中的链接、网站内部链接或网站地图被发现,这一过程可以理解为网址发现。
对于刚上线的独立站,清晰的网站导航、产品分类和内部链接可以帮助Google从首页进入产品页、文章页和其他重要页面。XML网站地图则可以集中提供网站中的重要网址,帮助Google了解网站包含哪些页面,但提交网站地图并不代表其中的页面一定会被抓取或收录。
Google发现网址后,可能会使用名为Googlebot的自动化抓取工具访问页面,下载页面中的文字、图片、视频及其他可用资源。Google会根据系统判断决定抓取哪些网站、多久抓取一次,以及每次抓取多少页面。
网站服务器异常、DNS错误、页面加载失败或访问速度长期不稳定,都可能影响Googlebot访问页面。robots.txt则主要用于控制搜索引擎爬虫可以请求哪些网址,如果重要产品页或文章页被错误禁止抓取,Google可能无法正常读取页面内容。
网站中的链接还需要能够被Google识别和访问。产品列表只有图片却没有清晰链接、重要内容必须点击复杂按钮后才能出现,或者页面长期处于登录状态,都可能增加Google发现和抓取内容的难度。
2. 页面被抓取后如何进入Google索引?
页面被抓取后,Google会处理和分析其中的文字、标题、图片、视频、Alt属性及其他页面信息,尝试判断页面主要表达什么内容。对于使用JavaScript生成内容的网站,Google还可能通过浏览器环境渲染页面并执行JavaScript,以查看最终能够显示的内容。
如果产品名称、介绍、参数或文章正文只能在用户点击后加载,或者JavaScript运行异常,Google看到的页面内容可能与访客实际看到的内容不同。企业需要保证页面主要内容能够稳定加载,并避免将重要产品信息完全依赖复杂互动后才显示。
分析页面时,Google还会识别页面语言、内容主题、图片和视频信息,并判断页面是否与其他网址重复或高度相似。如果多个网址展示相同或近似内容,Google可能将它们归为同一组,并从中选择更具有代表性的规范网页。
筛选参数、排序方式、HTTP与HTTPS版本、带有不同跟踪参数的网址,都可能产生内容相近的页面。企业可以通过规范网址、统一内部链接和合理设置页面结构,帮助Google理解希望主要展示的页面,但Google仍会综合多个信号选择其认为合适的规范版本。
符合条件的页面信息会被存储在Google索引中。页面进入索引后,才具备出现在Google搜索结果中的资格。不过,进入索引并不代表页面搜索任何关键词时都会展示,也不代表一定能够获得靠前排名。
3. 发现、抓取、收录和排名有什么区别?
网页被Google发现,只能说明Google已经知道这个网址存在,并不代表Googlebot已经访问页面。页面被抓取后,也不代表一定会被编入索引;进入索引后,还要等到页面与用户查询相关时,才可能出现在对应的搜索结果中。
因此,被发现、被抓取、被收录和获得排名是不同阶段。企业不能只根据页面是否能够在Google中搜索到,判断整个网站的SEO是否正常,也不能把提交网址理解为立即收录或获得排名。
页面未被收录可能与内容质量较低、页面重复、设置了noindex、服务器异常、网站结构不利于抓取或Google选择了其他规范网页有关。即使页面符合Google搜索要求,Google也不保证一定会抓取、编入索引或展示该页面。
robots.txt与noindex的作用也不相同。robots.txt主要用于管理爬虫访问,不能作为确保网页不出现在Google搜索结果中的方式;noindex则用于告诉Google不要将页面保留在搜索结果中,但Google需要能够抓取页面,才能读取其中的noindex规则。
米多多检查独立站收录问题时,会按照网址是否被发现、Googlebot能否访问、页面能否正常渲染、是否允许索引、规范网页是否正确的顺序逐项排查。这样可以判断问题发生在哪个环节,避免在抓取尚未正常时就反复修改关键词和文章内容。
4. 用户搜索后Google如何检索和排序?
用户在Google中输入搜索词后,系统会从已经建立的Google索引中查找与搜索需求相关的内容,而不是在用户搜索的瞬间重新抓取整个互联网。Google会分析查询中的词语、组合方式和可能表达的需求,再从索引中筛选相关页面。
找到相关内容后,Google会通过自动化排名系统对结果进行排序。排序过程中会综合考虑页面与查询的相关性、内容质量、页面可用性及用户搜索环境等多种因素,并尝试优先展示更相关和更有帮助的信息。
例如,不同国家和地区的用户搜索同一个词时,看到的结果可能不同;用户使用的语言、所在位置和访问设备,也可能影响搜索结果的内容与展示形式。对于具有明显地区需求的查询,本地相关信息可能获得更多展示机会。
Google的排名系统通常以具体页面为主要判断对象,同时也会参考部分网站层面的信号。某个网站整体表现较好,并不代表其中所有页面都会获得靠前排名;个别页面表现一般,也不代表整个网站的内容都无法展示。
完成检索和排序后,Google会将相应结果呈现在搜索结果页面中。根据查询内容不同,结果中可能出现普通网页、图片、视频、本地信息、商品及其他搜索功能。页面已经被收录,也只有在内容与用户查询具有相关性并符合相应展示要求时,才可能获得展示。
5. 独立站如何检查抓取、收录和搜索表现?
企业可以通过Google Search Console查看网站的抓取、索引和搜索表现。网址检查工具可以显示具体页面当前的索引状态,也可以测试实时网址,帮助企业了解Google能否访问页面及其读取到的相关信息。
网站地图可以通过Search Console提交,页面索引报告则可以用于查看哪些网址已经进入索引、哪些页面没有收录以及系统识别到的主要原因。对于重要的新页面或完成明显修改的页面,还可以根据实际情况提交抓取请求,但提交请求仍不代表页面一定会立即收录。
效果报告可以查看网站通过哪些搜索词获得展示和点击,并分析页面、国家、设备、展示次数、点击次数和平均排名等数据。企业可以据此判断目标关键词是否带来曝光,哪些页面已经获得访问,以及不同市场的搜索表现是否存在差异。
在米多多的独立站SEO内容运营中,Search Console数据通常会与产品更新、文章发布、页面结构和目标市场结合分析。如果页面长期没有被发现,需要检查链接与网站地图;如果已经抓取但未收录,需要检查内容、规范网页和索引设置;如果已经收录但没有展示,则需要进一步分析页面主题、搜索需求和内容质量。
企业还需要定期检查服务器状态、robots.txt、noindex、规范网址、内部链接、多语言页面和移动端内容,避免网站改版或功能调整后影响Google抓取与索引。SEO需要持续维护,不能在网站上线并提交网站地图后就停止检查。
Google搜索引擎工作原理常见问题
Q:提交网站地图后,页面会立即被Google收录吗?
A:不会。网站地图可以帮助Google发现网址,但不能保证页面立即被抓取或编入索引。
Q:页面被Googlebot抓取后是不是就代表已经收录?
A:不是。抓取后Google还会分析页面内容和索引条件,被抓取不等于被收录。
Q:页面已经收录,为什么搜索关键词时仍然找不到?
A:收录只代表页面具备参与搜索结果展示的资格,是否出现还取决于查询相关性、内容质量和排名系统判断。
Q:使用robots.txt能彻底阻止网页出现在Google吗?
A:不一定。robots.txt主要管理爬虫访问,网址仍可能通过其他链接被发现。需要阻止索引时,应根据实际情况使用noindex或访问权限控制。
Q:如何查看网页是否已被Google收录?
A:可以使用Google Search Console中的网址检查工具和页面索引报告,查看具体页面的抓取与索引状态。
米多多可以提供什么
围绕外贸独立站的Google自然搜索运营,米多多可以根据网站结构、产品分类和目标市场,协助检查网站地图、robots.txt、noindex、规范网址、内部链接和多语言页面等基础设置,并通过Google Search Console分析页面发现、抓取、索引、搜索词展示和点击情况。在内容运营方面,米多多还可以结合海外客户的搜索需求,规划产品页面、行业文章、常见问题和落地页内容,持续检查收录与搜索表现,使网站技术设置、内容更新和SEO数据复盘形成衔接。
推荐阅读